


Calvin Candie
Вечный

Calvin Candie
Вечный
- 2 Сен 2018
- 55,636
- 13,717
- #1
Голосов: 0
Автор: DrMax
Название: SEO Монстр 2027 (2026)
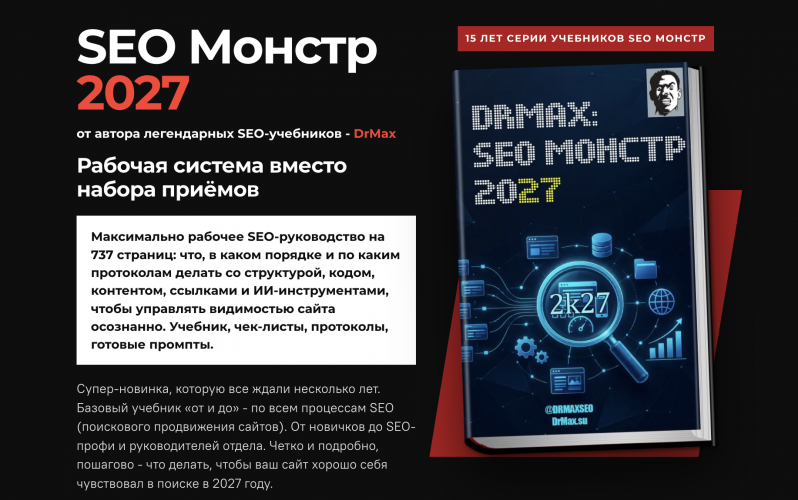
SEO-руководство посвящено технической диагностике сайтов, архитектуре страниц, контенту, ссылкам и применению ИИ в поисковом продвижении. Учебник охватывает работу с Google и рассматривает подходы, которые могут быть полезны и для продвижения в Яндексе.
Максимально рабочее SEO-руководство на 737 страниц: что, в каком порядке и по каким протоколам делать со структурой, кодом, контентом, ссылками и ИИ-инструментами, чтобы управлять видимостью сайта осознанно. Учебник, чек-листы, протоколы, готовые промпты.
Супер-новинка, которую все ждали несколько лет. Базовый учебник «от и до» - по всем процессам SEO (поискового продвижения сайтов). От новичков до SEO-профи и руководителей отдела. Четко и подробно, пошагово - что делать, чтобы ваш сайт хорошо себя чувствовал в поиске в 2027 году.
Подходит ли учебник для продвижения в Яндексе?
Учебник написан под Google, но практика показывает, что инновации, которые Google обкатывает сейчас, приходят в Яндекс через 2-3 года. Поэтому внедрение методологии из этой книги дает двойную отдачу: позволяет системно забирать трафик в Google уже сегодня и формирует многолетний технологический отрыв от конкурентов в выдаче Яндекса.
Платите за продвижение, а сайт стоит на месте?
Единый рабочий стандарт серии. Прошлые книги DrMax писал для узких специалистов, эту - для всей команды: SEO-инженеров, разработчиков, редакторов и владельцев сайтов, отвечающих за результат.
Хватит чинить сайт кусками
Вы закрыли очередную ошибку и всё равно не знаете, почему страница не растёт. Переписали заголовки, купили ссылки, добавили ключи, а результата нет. Пробуете ИИ для текстов, но получаете страницы, похожие на тысячи других.
Причина не в нехватке усилий, а в подходе. Список отдельных факторов не отвечает на вопрос, где именно ломается цепочка: на уровне индекса, архитектуры, самой страницы, доверия или внешних сигналов.
Не угадывать алгоритм. Проектировать сайт.
Поисковая система оценивает сайт последовательно - от технической проходимости и индекса до архитектуры, контента, доверия и внешних сигналов. Бессмысленно оптимизировать текст или закупать ссылки, пока робот упирается в ошибки обхода или каноникализации.
Диагностика проекта строится снизу вверх, а задачи делятся на три очереди: критические блокеры роста, шаблонные мультипликаторы и локальные эксперименты.
Не обзор алгоритма, а рабочее руководство
Таблицы, чек-листы, фрагменты кода и формулировки задач, которые можно сразу отдать в работу.
Нейросеть ускоряет. Человек проверяет
Книга встраивает ИИ в процесс так, чтобы он был точным инструментом, а не генератором спама. Черновая работа за моделью, факты и решения за человеком.
Пример рабочего дня
Десятки SEO-промптов и скиллов в главе 9. Для каждого инструмента: назначение, входные данные, результат и ограничения. Это карта того, что можно доверить модели, а что нужно проверять вручную.
Исследование и архитектура. Собрать структуру сайта и страниц до первой строки текста.
ИИ ускоряет кластеризацию и каркасы, но не штампует тексты, за которые сайт попадает под фильтры.
Без галлюцинаций
Каждое число, заголовок, описание, alt и блок разметки проверяет человек.
Без иллюзий
Оценки промптов - не измерения Google, а гипотезы, которые проверяются на ваших данных.
Что дает книга:
Часть I. Архитектура, техника, исполнение:
Задаёт модель работы поиска: многоступенчатый конвейер вместо списка факторов, Zero-Click и разбор запроса на подзадачи. Ценна как система диагностики: она помогает определить, на каком уровне возникла проблема видимости, и в каком порядке её решать.
1.1. Что изменилось в поиске — стр. 18
Объясняет, почему список «200 факторов» мешает работе, как устроена выдача с AI Overviews и как изменилось поведение пользователей. Даёт понимание пяти стадий ранжирования, на которое опираются все следующие главы.
Показывает сайт глазами Google: граф URL, рендеринг, индексацию, сущности и тематический вектор, сигналы качества и доверия. Помогает объяснить заказчику, почему «удобный» сайт может быть непрозрачным для поисковой машины.
Описывает типы обновлений и порядок реакции на них: не вносить правки во время раскатки, сравнивать когорты «до» и «после», отсеивать шум. Защищает от паники и ошибочных откатов после Core Update.
Формулирует новую логику работы: пять слоёв SEO-системы, конец автономного копирайтинга и способ отличить проблему страницы от проблемы раздела или сайта. Помогает выбрать масштаб вмешательства.
Учит приоритизации: что исправлять первым, как оценивать силу гипотезы по 18-балльной шкале и как не утонуть в бэклоге. Полезен руководителю и исполнителю при планировании спринтов.
Определяет границы применимости языковых моделей в SEO: первичная диагностика выгрузок, анализ выдачи и конкурентов, протокол ручной проверки. Даёт безопасные сценарии работы с ИИ без риска получить уверенно написанную ошибку.
Глава 2. Технический фундамент: краулинг, рендеринг и архитектура индексации (стр. 60)
Описывает инженерный фундамент сайта: краулинг, robots.txt, индексацию, каноникализацию, карты сайта, коды ответов, дубли, пагинацию, JavaScript, скорость и hreflang. Без этого слоя дальнейшая работа с контентом и ссылками не даёт отдачи, поэтому глава служит чек-листом технического аудита.
2.1. Управление краулингом и бюджетом сканирования (Crawl Budget) — стр. 60
Показывает, как расходуется краулинговый бюджет, какие типы страниц его «съедают» и как найти ловушки сканирования восемью методами. Ценен для крупных сайтов, где индекс засоряется параметрами и дублями.
Разбирает robots.txt по стандарту RFC 9309, механику директив и запрет блокировки CSS и JavaScript. Содержит энциклопедию из 20 типовых ошибок, которая сразу применима при аудите.
Объясняет, как документ проходит отбор в индекс, как читать 14 статусов отказа в Search Console и почему Google игнорирует canonical. Помогает управлять тем, какие страницы попадут в активный индекс.
Описывает sitemap.xml как декларацию канонического инвентаря: какие URL включать, какие нельзя, как строить кластерные карты. Даёт диагностические приёмы по расхождению карты и индекса.
Объясняет значение кодов 200, 301, 302, 404, 410 и 503 для обработки страниц и накопления сигналов. Включает цепочки редиректов, проверку при миграции и выбор между 404 и 410.
Разделяет технические и смысловые дубли, параметры, сортировки и фильтры. Даёт шаблон решения: индексировать, канонизировать, закрыть или объединить - полезный для интернет-магазинов.
Показывает, почему пагинация нарушает передачу сигналов, как оформлять последовательные страницы и как аудировать списки по семи точкам контроля. Разбирает бесконечную прокрутку и кнопку «Показать ещё».
Описывает mobile-first индексацию и последствия клиентского рендеринга: потерю контента и разметки. Даёт способы проверить, что робот видит основной контент, включая пакетный поиск проблем с помощью ИИ.
Объясняет метрики LCP, CLS и INP, различие лабораторных и полевых данных и порядок диагностики на уровне шаблонов. Помогает ставить разработчикам задачи по скорости без переписывания фронтенда.
Определяет, когда hreflang необходим, перечисляет десять частых ошибок и методику проверки языковых кластеров. Полезен для мультиязычных и мультирегиональных проектов.
Собирает техническую диагностику в рабочий процесс: порядок первичного разбора в GSC, сведение данных краулера, сервера и индексации, группировка задач с помощью ИИ и контроль регрессий. Превращает разовый аудит в регулярную практику.
Глава 3. Внутренняя оптимизация страницы (on-page SEO) (стр. 156)
Описывает оптимизацию отдельной страницы как решение задачи пользователя: интент, сущности, извлекаемые блоки, сниппет, изображения, микроразметка и шаблоны. Практичность главы в готовых правилах для семи типов страниц и регламентах проверки.
3.1. Типы страниц и правила их профильной оптимизации — стр. 157
Даёт профильные правила для главной, категории, карточки товара, услуги, статьи, локальной страницы и страницы онлайн-инструмента. Позволяет собрать ТЗ на страницу по её роли в архитектуре.
Разбирает проектирование Title и Description: как писать их под задачу, почему Google их переписывает, как влияют AI-ответы на CTR. Содержит матрицы шаблонов по типам страниц и пакетную подготовку черновиков.
Определяет полезный основной контент через вложенный труд и оригинальность, учит писать полно и коротко и отсекать мусорный объём. Отдельно разбирает таблицы для извлечения данных ИИ-системами.
Описывает работу с сущностями, характерными терминами и смысловой полнотой документа. Помогает превратить текст из набора ключевых фраз в описание конкретного объекта с проверяемыми атрибутами.
Систематизирует элементы сниппета и расширенных результатов: название сайта, иконки, структурные блоки, визуальные элементы. Помогает решать, какие улучшения заметности стоит делать на конкретной странице.
Показывает, как изображения участвуют в оценке оригинальности и подтверждении опыта: alt, figcaption, оригинальные медиа, пакетная работа и генерация сценариев по маске продукта. Ценен для e-commerce и экспертных обзоров.
Описывает микроразметку Schema как машиночитаемый слой сущностей и связный граф JSON-LD. Даёт практику проверки, где разметка должна совпадать с видимым содержанием страницы.
Собирает всё в шаблоны внутренней оптимизации для CMS и регламенты проверки страниц, включая защиту лидеров через Protected Cohort. Ценен при массовых обновлениях, чтобы не потерять трафик.
Глава 4. Архитектура сайта и внутренняя перелинковка (стр. 277)
Поднимает оптимизацию с уровня страницы на уровень домена: тематический фокус, роли страниц, хабы, перелинковка и отраслевые архитектуры. Помогает проектировать структуру, которая накапливает авторитет, а не размывает его.
4.1. Тематический фокус сайта и векторные границы домена — стр. 277
Объясняет тематический фокус как измеряемую концентрацию домена вокруг связанных тем и его векторные границы. Даёт аргументы для тематической чистки и отказа от нецелевых разделов.
Описывает иерархию разделов и роли страниц от главной к целевым, смешанным и вспомогательным, а также реконструкцию запутанной структуры. Содержит матрицу решений по каждому URL при перестройке старых сайтов.
Раскрывает хабы, кластеры и семантические коконы как одну архитектурную идею с разной детализацией. Помогает выбирать модель тематического узла под размер и тип проекта.
Показывает внутреннюю перелинковку как управление передачей веса и пониманием сайта: типы ссылок, анкоры, анкорные листы. Практически применим для расчёта ссылок между материнскими, дочерними и сестринскими страницами.
Даёт архитектуру коммерческого каталога: какие страницы борются за спрос, какие поддерживают, какие закрываются. Разбирает фильтры, карточки, подборки и сравнения для интернет-магазинов.
Описывает распределение спроса по страницам сайта услуг: услуги, города, специализации и проблемы клиентов. Помогает избежать каннибализации и шаблонных гео-страниц.
Предлагает архитектуру медиа, баз знаний и корпоративных журналов, где публикации накапливают тематический авторитет. Показывает, как связывать материалы, чтобы не плодить сироты и дубли.
Объясняет, как масштабировать проект, не снижая качества: расширение ядра, контроль новых документов, повторные проверки. Полезен командам, которые наращивают число страниц.
Глава 5. Качество, доверие, локальное SEO и рабочие процессы (стр. 392)
Объединяет качество сайта, E-E-A-T, YMYL, авторов, локальное SEO, ИИ в производстве контента, измерение и постоянные улучшения. Практическая ценность главы - проверяемая инфраструктура доверия и операционный ритм команды.
5.1. Качество сайта глазами Google — стр. 393
Показывает, как поиск оценивает качество на уровне документа, раздела и домена, и какие общесайтовые сигналы диагностировать. Помогает отличить локальную проблему от проблемы проекта.
Разбирает E-E-A-T как инфраструктуру доверия, а не набор плашек: ответственность бизнеса, подтверждение опыта, прозрачность. Даёт список элементов, которые можно внедрить и проверить.
Описывает зоны YMYL по руководству для асессоров и повышенные требования к ним. Помогает выстроить редакционную проверку и дисклеймеры для финансовых, медицинских и юридических тем.
Показывает, как строить профили авторов, редакционную политику и внешнюю репутацию. Важен для доказательства опыта автора, которое поиск проверяет вне сайта.
Описывает локальное SEO: офлайн-интент, Google Business Profile, согласованность NAP и синхронизацию гео-кластеров. Полезен филиальным сетям и локальному бизнесу.
Определяет, как использовать ИИ в контент-процессах без риска масштабного спама: критерии отбраковки, роли человека, проверка фактов. Даёт регламент для редакционного конвейера.
Разделяет рост трафика на видимость, кликабельность и результат после клика и учит измерять каждый слой. Помогает строить отчёты, по которым можно принимать решения.
Описывает цикл улучшений, а не разовые кампании: ревизии, обновления, еженедельный ритм и очереди задач. Превращает SEO в управляемый процесс.
Глава 6. Линкбилдинг (стр. 471)
Рассматривает ссылки и упоминания как мультипликатор уже подготовленной системы: естественный профиль, выбор страниц-акцепторов, белые методы, анализ конкурентов, риски и учёт. Ценна тем, что связывает внешние сигналы с внутренней архитектурой.
6.1. Роль ссылок в 2026-2027 годах — стр. 473
Объясняет изменение роли ссылок в 2026-2027 годах: от точечного усиления запроса к подтверждению авторитета сущностей и распределению веса по кластеру. Задаёт ожидания от линкбилдинга.
Описывает признаки естественного и сбалансированного профиля, соответствующего бизнесу и тематике. Помогает оценивать свой профиль и профили конкурентов.
Учит выбирать страницы-акцепторы и готовить их до получения ссылок. Предупреждает, что неподготовленная страница поглощает ресурс даже сильных внешних ссылок.
Собирает белые методы получения ссылок: цифровой PR, данные, экспертные комментарии, партнёрские материалы. Полезен как набор рабочих сценариев с понятными условиями.
Показывает, как работать с существующими упоминаниями бренда, нелинкованными и некорректными ссылками. Это самый дешёвый источник ссылок для проектов с узнаваемостью.
Описывает анализ ссылочных стратегий конкурентов, включая ИИ-поддержку. Помогает понять, за что конкурентам ссылаются и какие активы нужны для сопоставимых размещений.
Разбирает риски: токсичные размещения, исчезающие ссылки, бесполезный трафик. Даёт критерии защиты бюджета и проверки подрядчиков.
Предлагает систему планирования, учёта и связи линкбилдинга с развитием сайта. Позволяет отследить путь от темы и материала до публикации и результата.
Описывает нестандартные приёмы: инструменты, цитируемые данные, воспроизводимые расчёты и профессиональный вклад. Полезен для получения ссылок в нишах, где обычный аутрич слабо работает.
Описывает цикл доказательного исследования до написания текста: данные, связки, интенты, кластеры, проверка необходимости страницы через TGA и ядро страницы по GIST. Ценность главы - методика, которая позволяет не создавать лишних страниц и не писать «воду».
7.1. Постановка задачи и границы исследования — стр. 569
Показывает, как поставить исследовательскую задачу и определить её границы на примере магазина. Помогает избежать сбора запросов без цели.
Описывает сбор и проверку исходных данных: обращения, отзывы, страницы сайта и конкурентов, выгрузки. Задаёт стандарт, на который опираются выводы.
Учит строить исследовательские связки от широкого поиска к проверке и отличать повторяющийся сигнал от единичного случая. Снижает риск принимать случайность за закономерность.
Раскрывает интенты, модификаторы и задачи пользователей. Помогает определить, какое решение стоит за запросом, и как оно влияет на тип страницы.
Описывает кластеризацию формулировок и проверку по выдаче. Показывает, когда запросы можно объединять, а когда они требуют разных ответов.
Сопоставляет аудиторию, сайт и конкурентов, чтобы выявить реальные дефициты, а не копировать чужие блоки. Помогает решать, нужна ли конкурентная таблица или блок.
Объясняет, как проверить через TGA, нужна ли отдельная страница или тема должна войти в существующую. Защищает от каннибализации и разрастания индекса.
Описывает метод GIST: определить ядро страницы и отобрать смысловые блоки без избыточности. Даёт способ избежать «полного» документа, где нужное теряется.
Показывает, как разделять подтверждённые сведения и гипотезы и когда нужно углубление исследования. Определяет статус доказательств перед публикацией.
Содержит практикум GIST: задание, документ, метаданные и аудит с сохранением версий и оснований изменений. Годится как регламент для редактора.
Описывает итоговую карту страниц и передачу результатов исследования в проектирование. Помогает собрать пакет, который можно передать архитектору и редакции.
Переводит исследование в архитектуру семантических коконов 4.0 на базе Cocoon Engine X4: границы, роли страниц, структурный дом, ссылки, факты и внедрение. Ценность - единая система планирования и обновления раздела, а не набор статей.
8.1. От модели 3.1 к семантическому кокону 4.0 — стр. 669
Объясняет переход от модели 3.1 к кокону 4.0 как управляемой системе ответов на связанные задачи. Показывает, чем он отличается от классического кластера.
Описывает подготовку материалов и рабочей сессии Cocoon Engine X4. Предупреждает, что устаревшие исходные данные искажают дальнейшие решения.
8.3. Границы кокона и граф сущностей — стр. 679
Показывает, как определить границы кокона и построить граф сущностей. Помогает отделить соседние направления от основного раздела.
8.4. Роли страниц и состав выпуска — стр. 681
Описывает роли страниц и состав выпуска. Позволяет планировать объём работ и не пытаться закрыть все задачи одним документом.
8.5. Единственный структурный дом и смысловые мосты — стр. 683
Вводит правило единственного структурного дома и смысловые мосты. Защищает от дублирования и обеспечивает переходы между связанными задачами.
8.6. Внутренние ссылки и их контекст — стр. 685
Учит проектировать внутренние ссылки с контекстом: какое действие поддерживает каждый переход. Даёт редактору понятные указания для размещения.
8.7. Контент кокона и проверка GIST — стр. 687
Описывает содержание кокона и проверку его через GIST. Объясняет, когда решение возвращается на архитектурный уровень.
8.8. Единый источник изменяемых фактов — стр. 689
Вводит единый источник изменяемых фактов: цен, совместимости, условий. Предотвращает противоречия между карточками, руководствами и метаданными.
8.9. Передачи и критерии готовности — стр. 691
Описывает передачи между этапами и критерии готовности. Помогает фиксировать, какие выводы подтверждены, а какие остаются предварительными.
8.10. Внедрение и проверка опубликованного кокона — стр. 693
Показывает, как внедрять кокон поэтапно и проверять опубликованные страницы. Снижает риски ошибок шаблона и адресов.
8.11. Аудит и точечное обновление — стр. 695
Описывает аудит и точечное обновление кокона при изменении продукта, аудитории или источников. Сохраняет основания прежних решений.
8.12. Сквозные практикумы и собственные связки — стр. 697
Содержит сквозные практикумы и способы собирать собственные связки. Показывает формы документов и решений, которые можно ожидать на каждом шаге.
8.13. Chainsmith - подготовка и выполнение маршрутов Cocoon Engine X4 — стр. 699
Описывает Chainsmith - мета-промпт, который собирает последовательность команд для Cocoon Engine X4. Упрощает освоение системы и подготовку маршрута под задачу.
Глава 9. Авторские инструменты для SEO - промпты, скиллы и рабочие связки (стр. 703)
Даёт справочник авторских промптов и скиллов с назначением, входными данными, результатом и ограничениями каждого. Ценен как карта инструментов, где указано, что можно доверить модели, а что нужно проверять вручную.
9.1. Cocoon Engine X4 и инструменты работы с ним — стр. 703
Описывает Cocoon Engine X4, Chainsmith, TGA, GIST, Reddit Mapper и GEO Structure Optimizer. Помогает выбрать инструмент для исследования, архитектуры, контента или структуры готовой страницы.
Описывает BrandCore и BrandCore Navigator как проверяемый источник фактов о компании и Market-Scoped Differentiation как инструмент адаптации под рынки. Нужен при регулярном производстве контента для одного бренда.
Собирает инструменты исследования тем и спроса: Trend Discovery, InfoGapRadar, Latent Intent Analyst и Forensic SEO Due Diligence. Результаты рассматриваются как гипотезы для проверки.
Описывает SEO TITAN OS, аудит по пайплайну ранжирования и SERP Barrier Breaker. Подчёркивает, что оценки промптов - не измерения Google.
Описывает проверку и редактирование содержания: эмуляторы асессора, CVD, LinguaForensic, TEXT HUMANIZATION, LexAdapt и VeriScan. Разделяет оценку, диагностику и редактуру.
Описывает SemanticRank Orchestrator, CHUNK SENTINEL и LSI 2.0 Auditor - проверку HTML-разметки и деления на фрагменты. Объясняет, когда достаточно структурной правки, а когда нужен анализ HTML.
Описывает Entity Footprint System, Brand Entity Poisoning Forensics и Regulatory & Risk Scanner. Помогает находить расхождения о бренде и чувствительные утверждения до публикации.
Описывает Listicle Citation Engine, SignalForge и PromptSculptor. Закрывает внешние упоминания, контролируемые эксперименты и обслуживание рабочих промптов.
Сводит методологию обеих частей в единую систему координат и даёт порядок внедрения от технического фундамента до производства на TGA, GIST и Cocoon Engine X4. Полезно как финальный чек-лист приоритетов.
Приложения: чек-листы, промпт и команды (стр. 725)
Содержат рабочие чек-листы, промпт и справочник команд, которые можно использовать без перечитывания глав. Ценны как готовые инструменты для повседневной работы.
Приложение 1. Чек-лист по диагностике сайта после апдейта Google (стр. 725)
Чек-лист анализа сайта после апдейта Google, который запускают после завершения выкатки и паузы минимум в неделю. Помогает отделить реальное влияние от шума.
Приложение 2. Быстрый чек-лист по robots.txt для любого типа сайта (стр. 728)
Краткий чек-лист проверки robots.txt для любого типа сайта. Позволяет быстро выявить критические ошибки перед детальным аудитом.
Приложение 3. Промпт: Link Target Readiness Analyzer (стр. 729)
Промпт Link Target Readiness Analyzer для оценки готовности страницы принимать внешние ссылки. Помогает выбирать акцепторы до запуска линкбилдинга.
Приложение 4. Команды Cocoon Engine X4 (стр. 732)
Справочник команд Cocoon Engine X4 по реестру CP-Navigator v1.9: управление сессией, задачи, исследование, архитектура, GIST, экспорт и ввод задания простым текстом. Нужен для работы с системой без поиска по документации.
Автор DrMax
Подробнее:
Скачать:
Название: SEO Монстр 2027 (2026)
SEO-руководство посвящено технической диагностике сайтов, архитектуре страниц, контенту, ссылкам и применению ИИ в поисковом продвижении. Учебник охватывает работу с Google и рассматривает подходы, которые могут быть полезны и для продвижения в Яндексе.
Максимально рабочее SEO-руководство на 737 страниц: что, в каком порядке и по каким протоколам делать со структурой, кодом, контентом, ссылками и ИИ-инструментами, чтобы управлять видимостью сайта осознанно. Учебник, чек-листы, протоколы, готовые промпты.
Супер-новинка, которую все ждали несколько лет. Базовый учебник «от и до» - по всем процессам SEO (поискового продвижения сайтов). От новичков до SEO-профи и руководителей отдела. Четко и подробно, пошагово - что делать, чтобы ваш сайт хорошо себя чувствовал в поиске в 2027 году.
- 737 страниц
- 9 глав
- 4 приложения
- 5 уровней ранжирования
- Десятки авторских SEO-промптов
- 15 лет серии учебников SEO Монстр
- Владелец бизнеса или сайта
- Поймете, за что платите подрядчику, что принимать в работу и в каком порядке
- SEO перестанет быть черным ящиком, в который уходят деньги
- Маркетолог
- Увидите, почему просел трафик, и отличите причину от шума
- Эксперт и автор
- Статьи, которые находят люди и которые есть за что цитировать нейросетям
- Начинающий SEO
- Цельная картина профессии вместо набора разрозненных приемов
- Опытный SEO
- Диагностика по уровням, три очереди задач и авторский ИИ-стек DrMax
- Разработчик
- Готовые требования к рендерингу, canonical, картам сайта и разметке
- Редактор
- Страницы под задачу человека, а не под список ключей
- ИИ в процессе без потери качества
- Узнаете, как сегодня устроен поиск: почему Google и ответы нейросетей показывают одни сайты и не замечают другие
- Поймете, где именно ваш сайт теряет видимость: в технике, структуре, страницах, доверии или ссылках
- Научитесь работать с выдачей, где над ссылками стоят ответы нейросетей
- Встроите ИИ в работу так, чтобы он ускорял, а не плодил спам
- Ответ без клика
- Над ссылками теперь ответы нейросети
- Простые вопросы закрываются прямо в выдаче. Клик достается сайту, который дает больше, чем пересказ в три строчки
- Отбор на входе
- Не каждая страница попадает в индекс
- Google отсеивает страницы еще до ранжирования. Новые разделы месяцами висят со статусом «просканирована, но не проиндексирована»
- ИИ без контроля
- Тексты от нейросети тянут сайт вниз
- Массовая генерация без проверки размывает тему сайта и рискует попасть под фильтры за масштабный спам
Подходит ли учебник для продвижения в Яндексе?
Учебник написан под Google, но практика показывает, что инновации, которые Google обкатывает сейчас, приходят в Яндекс через 2-3 года. Поэтому внедрение методологии из этой книги дает двойную отдачу: позволяет системно забирать трафик в Google уже сегодня и формирует многолетний технологический отрыв от конкурентов в выдаче Яндекса.
Платите за продвижение, а сайт стоит на месте?
Единый рабочий стандарт серии. Прошлые книги DrMax писал для узких специалистов, эту - для всей команды: SEO-инженеров, разработчиков, редакторов и владельцев сайтов, отвечающих за результат.
- Владелец
- Платим подрядчику каждый месяц, а что он делает, непонятно
- Отчеты приходят, позиции скачут, и не на что опереться, чтобы задать вопрос
- Маркетолог
- Трафик просел, и никто не может объяснить почему
- Апдейт, сезонность, козни конкурентов или технический сбой? Причину просадки невозможно отличить от общего шума
- Эксперт
- Пишу сильные статьи, а их никто не находит
- На вопрос читателя теперь отвечает нейросеть прямо в выдаче, и до сайта человек не доходит
- SEO-специалист
- После апдейта переписали все тексты на сайте, а позиции только упали
- Непонятно, на каком уровне случилась переоценка: страницы, раздела или всего сайта
- Редактор
- Массово нагенерили статей, а в индекс попадают единицы
- Страницы висят «просканирована, но не проиндексирована», и кнопка отправки не помогает
- Разработчик
- Сделали редизайн, а позиции рухнули
- Поменяли шаблоны, адреса или движок, и поиск заново переоценил сайт. Где именно сломалось, непонятно
Хватит чинить сайт кусками
Вы закрыли очередную ошибку и всё равно не знаете, почему страница не растёт. Переписали заголовки, купили ссылки, добавили ключи, а результата нет. Пробуете ИИ для текстов, но получаете страницы, похожие на тысячи других.
Причина не в нехватке усилий, а в подходе. Список отдельных факторов не отвечает на вопрос, где именно ломается цепочка: на уровне индекса, архитектуры, самой страницы, доверия или внешних сигналов.
Не угадывать алгоритм. Проектировать сайт.
- Поправили заголовки
Google перепишет их в выдаче, если страница не отвечает на запрос - Добавили ключевые слова
Поиск давно читает смысл и задачу страницы, а не частоту слов - Докупили ссылок
Вес уходит в страницы, которые не попали в индекс или конкурируют друг с другом - Нагенерили статей нейросетью
Тема сайта размывается, а массовые тексты рискуют попасть под фильтры за спам
Поисковая система оценивает сайт последовательно - от технической проходимости и индекса до архитектуры, контента, доверия и внешних сигналов. Бессмысленно оптимизировать текст или закупать ссылки, пока робот упирается в ошибки обхода или каноникализации.
Диагностика проекта строится снизу вверх, а задачи делятся на три очереди: критические блокеры роста, шаблонные мультипликаторы и локальные эксперименты.
- Техника и индекс — глава 2
- Архитектура разделов — главы 4, 8
- Страница — главы 3, 7
- Доверие и поведение — глава 5
- Авторитет и ИИ — главы 6, 9
Не обзор алгоритма, а рабочее руководство
Таблицы, чек-листы, фрагменты кода и формулировки задач, которые можно сразу отдать в работу.
- 5 стадий конвейера Google и с чего начинать диагностику
- 7 типов страниц с правилами сборки
- 20 ошибок в robots.txt
- 14 статусов отказа в Search Console с расшифровкой
- 8 методов поиска ловушек сканирования
- 18 баллов в шкале силы гипотезы
- 3 очереди задач: блокеры, мультипликаторы, эксперименты
- Десятки SEO-промптов и скиллов автора
Нейросеть ускоряет. Человек проверяет
Книга встраивает ИИ в процесс так, чтобы он был точным инструментом, а не генератором спама. Черновая работа за моделью, факты и решения за человеком.
Пример рабочего дня
- ИИ группирует запросы и собирает каркасы страниц
- Человек проверяет каждое число, заголовок, описание и разметку
- ИИ находит дубли и страницы без входящих ссылок
- Человек решает, что удалить, что склеить, и отвечает за результат
- Первичная диагностика сайта — гл. 1
От сырых выгрузок к карте аномалий: модель находит, где копать - Реверс-инжиниринг выдачи и конкурентов — гл. 1
Извлечение сущностей, интентов и структуры страниц из топа - Пакетный поиск проблем с отрисовкой — гл. 2
ИИ-помощник находит участки, которые Google видит не полностью - Таблицы, которые ИИ берет в ответы — гл. 3
Как верстать данные, чтобы их извлекали генеративные системы - Редакционные ИИ-конвейеры — гл. 5
Производство контента командой в ритме, без потери качества - Ссылки под ИИ-цитирование — гл. 6
Неочевидные критерии выбора акцепторов и проектирование под цитаты нейросетей - Разбор ссылок конкурентов с ИИ — гл. 6
Анализ контекста, сущностей и перехват ссылочного распада - Протокол ручной проверки — гл. 1, 9
Human-in-the-Loop: что можно доверить модели, а что проверять вручную
Десятки SEO-промптов и скиллов в главе 9. Для каждого инструмента: назначение, входные данные, результат и ограничения. Это карта того, что можно доверить модели, а что нужно проверять вручную.
Исследование и архитектура. Собрать структуру сайта и страниц до первой строки текста.
- Cocoon Engine X4
- COCOON CHAINSMITH v3
- TGA Navigator
- GIST Content Logic
- Reddit Mapper V2
- GEO Structure Optimizer
- Trend Discovery 4.0
- InfoGapRadar
- Latent Intent Analyst v2.2
- Forensic SEO Due Diligence
- SEO TITAN OS
- Аудит по пайплайну Google
- SERP Barrier Breaker
- Эмуляторы асессора
- CVD v2.3
- LinguaForensic
- TEXT HUMANIZATION by DrMax
- LexAdapt v1.5
- VeriScan v1.6
- SemanticRank Orchestrator
- CHUNK SENTINEL
- LSI 2.0 Auditor
- BrandCore Navigator
- Market-Scoped Differentiation
- Entity Footprint System
- Brand Entity Poisoning Forensics
- Regulatory & Risk Scanner
- Listicle Citation Engine
- SignalForge
- Link Target Readiness Analyzer
- PromptSculptor
- Команды Cocoon Engine X4
ИИ ускоряет кластеризацию и каркасы, но не штампует тексты, за которые сайт попадает под фильтры.
Без галлюцинаций
Каждое число, заголовок, описание, alt и блок разметки проверяет человек.
Без иллюзий
Оценки промптов - не измерения Google, а гипотезы, которые проверяются на ваших данных.
Что дает книга:
- Систему диагностики сайта по уровням
- Порядок работ: что сначала, что потом
- Инструменты, чтобы проверять гипотезы на своих данных
Часть I. Архитектура, техника, исполнение:
- Разбор пяти стадий ранжирующего конвейера и порядок диагностики после Core Update
- Управление Crawl Budget, 8 методов поиска ловушек сканирования, энциклопедия из 20 ошибок robots.txt, расшифровка 14 статусов отказа в Search Console
- Правила сборки семи типов страниц: главная, категория, карточка товара, услуга, статья, локальный филиал и страница онлайн-инструмента
- Таблицы для извлечения ИИ-системами, связный граф JSON-LD и безопасный раскат шаблонов
- Тематический фокус сайта, чистка слабых страниц, роли Target → Mixed → Support и перелинковка
- Проверяемое доверие, стандарты для YMYL, локальное SEO и ритм команды
- Ссылки и упоминания бренда: цитируемые активы, белые методы, защита бюджета
Задаёт модель работы поиска: многоступенчатый конвейер вместо списка факторов, Zero-Click и разбор запроса на подзадачи. Ценна как система диагностики: она помогает определить, на каком уровне возникла проблема видимости, и в каком порядке её решать.
1.1. Что изменилось в поиске — стр. 18
Объясняет, почему список «200 факторов» мешает работе, как устроена выдача с AI Overviews и как изменилось поведение пользователей. Даёт понимание пяти стадий ранжирования, на которое опираются все следующие главы.
- 1.1.1. Почему SEO нельзя сводить к "факторам ранжирования" — стр. 18
- 1.1.2. Архитектура современной выдачи: классический SERP, AI Overviews и экономика нулевого клика — стр. 19
- 1.1.3. Эволюция пользовательского поведения: почему позиции в топе больше не гарантируют результат — стр. 23
- 1.1.4. Архитектура ранжирования Google — стр. 26
Показывает сайт глазами Google: граф URL, рендеринг, индексацию, сущности и тематический вектор, сигналы качества и доверия. Помогает объяснить заказчику, почему «удобный» сайт может быть непрозрачным для поисковой машины.
- 1.2.1. Краулинг и рендеринг: борьба за бюджет обхода — стр. 33
- 1.2.2. Индексирование, каноникализация и триггеры повторного обхода — стр. 34
- 1.2.3. Извлечение сущностей, вектор темы и семантический фокус сайта — стр. 35
- 1.2.4. Матрица качества, полезности и доверия (Quality & Demotion Signals) — стр. 36
- Резюме раздела 1.2 — стр. 37
Описывает типы обновлений и порядок реакции на них: не вносить правки во время раскатки, сравнивать когорты «до» и «после», отсеивать шум. Защищает от паники и ошибочных откатов после Core Update.
- 1.3.1. Core Updates: переоценка конкурентной среды вместо «поиска штрафа» — стр. 38
- 1.3.2. Табу на реакцию во время раскатки — стр. 39
- 1.3.3. Методология когортного сравнения: как правильно сводить данные «До» и «После» — стр. 40
- 1.3.4. Отсев статистического шума — стр. 41
Формулирует новую логику работы: пять слоёв SEO-системы, конец автономного копирайтинга и способ отличить проблему страницы от проблемы раздела или сайта. Помогает выбрать масштаб вмешательства.
- 1.4.1. Пять слоев SEO-системы: от техники до внешних сигналов — стр. 42
- 1.4.2. Смерть автономного копирайтинга — стр. 43
- 1.4.3. Как отличить проблему страницы от проблемы раздела и сайта — стр. 44
Учит приоритизации: что исправлять первым, как оценивать силу гипотезы по 18-балльной шкале и как не утонуть в бэклоге. Полезен руководителю и исполнителю при планировании спринтов.
- 1.5.1. Что исправлять сначала: индексирование, шаблоны, коммерческие страницы или контент — стр. 46
- 1.5.2. Как считать силу гипотезы — стр. 47
- 1.5.3. Как не утонуть в бесконечном списке задач — стр. 49
Определяет границы применимости языковых моделей в SEO: первичная диагностика выгрузок, анализ выдачи и конкурентов, протокол ручной проверки. Даёт безопасные сценарии работы с ИИ без риска получить уверенно написанную ошибку.
- 1.6.1. Границы применимости LLM — стр. 52
- 1.6.2. ИИ в первичной диагностике сайта: от сырых выгрузок к карте аномалий — стр. 54
- 1.6.3. Реверс-инжиниринг выдачи и конкурентов: извлечение сущностей, интентов и структуры — стр. 54
- 1.6.4. Протокол ручной верификации (Human-in-the-Loop — стр. 55
Глава 2. Технический фундамент: краулинг, рендеринг и архитектура индексации (стр. 60)
Описывает инженерный фундамент сайта: краулинг, robots.txt, индексацию, каноникализацию, карты сайта, коды ответов, дубли, пагинацию, JavaScript, скорость и hreflang. Без этого слоя дальнейшая работа с контентом и ссылками не даёт отдачи, поэтому глава служит чек-листом технического аудита.
2.1. Управление краулингом и бюджетом сканирования (Crawl Budget) — стр. 60
Показывает, как расходуется краулинговый бюджет, какие типы страниц его «съедают» и как найти ловушки сканирования восемью методами. Ценен для крупных сайтов, где индекс засоряется параметрами и дублями.
- 2.1.1. Механика обхода и многоуровневое хранение индекса — стр. 61
- 2.1.2. Анатомия утечек: 7 типов страниц, пожирающих краулинговый бюджет — стр. 65
- 2.1.3. Детекция ловушек сканирования — стр. 70
- Метод 1. Диагностика симптомов в отчете «Индексирование → Страницы» (GSC) — стр. 70
- Метод 2. Краулинг с поиском комбинаторных и структурных аномалий — стр. 71
- Метод 3. Анализ серверных логов (Log File Analysis) — стр. 71
- Метод 4. Инспекция отрендеренного DOM через «Проверку URL» (GSC) — стр. 72
- Метод 5. Экспресс-разведка индекса через связку операторов site: и inurl: — стр. 72
- Метод 6. Ручная эмуляция маршрута Googlebot в браузере — стр. 73
- Метод 7. Мониторинг дельты уникальных URL в логах по неделям — стр. 73
- Метод 8. Аудит медиа-ловушек и динамических ресайзов изображений (Image Crawl Traps) — стр. 73
Разбирает robots.txt по стандарту RFC 9309, механику директив и запрет блокировки CSS и JavaScript. Содержит энциклопедию из 20 типовых ошибок, которая сразу применима при аудите.
- 2.2.1. Локализация файла, стандарт RFC 9309 и флаг isRoboted — стр. 75
- 2.2.2. Механика директив: User-agent, Disallow, Allow, спецсимволы и Sitemap — стр. 76
- 2.2.3. Табу на блокировку CSS и JavaScript: почему запрет статики убивает ранжирование — стр. 78
- 2.2.4. Энциклопедия из 20 типовых ошибок в robots.txt (WordPress, E-commerce, Сайты услуг) — стр. 79
Объясняет, как документ проходит отбор в индекс, как читать 14 статусов отказа в Search Console и почему Google игнорирует canonical. Помогает управлять тем, какие страницы попадут в активный индекс.
- 2.3.1. Четыре фильтра на пути документа в поисковый индекс — стр. 85
- 2.3.2. Точечное управление через Meta Robots и X-Robots-Tag — стр. 87
- 2.3.3. Дешифровка отчета «Индексирование → Страницы» в GSC: 14 статусов отказа — стр. 89
- 2.3.4. Инженерия rel="canonical": почему Google игнорирует вашу подсказку и как управлять склейкой в CompositeDoc — стр. 93
Описывает sitemap.xml как декларацию канонического инвентаря: какие URL включать, какие нельзя, как строить кластерные карты. Даёт диагностические приёмы по расхождению карты и индекса.
- 2.4.1. Какие URL обязаны быть в sitemap.xml — стр. 96
- 2.4.2. Черный список Sitemap: 10 типов URL, разрушающих доверие к карте — стр. 97
- 2.4.3. Кластерная архитектура sitemap_index.xml — стр. 98
- 2.4.4. Sitemap и диагностика сайта — стр. 100
Объясняет значение кодов 200, 301, 302, 404, 410 и 503 для обработки страниц и накопления сигналов. Включает цепочки редиректов, проверку при миграции и выбор между 404 и 410.
- 2.5.1. Коды 200, 301, 302, 404, 410, 503 и их значение для SEO — стр. 103
- 2.5.2. Цепочки редиректов и размытие сигналов — стр. 105
- 2.5.3. Массовая проверка редиректов при миграции сайта — стр. 106
- 2.5.4. Выбор между 404 и 410: когда необходим код 410 Gone — стр. 108
Разделяет технические и смысловые дубли, параметры, сортировки и фильтры. Даёт шаблон решения: индексировать, канонизировать, закрыть или объединить - полезный для интернет-магазинов.
- 2.6.1. Технические дубли и смысловые дубли — стр. 111
- 2.6.2. URL с параметрами, сортировками и фильтрами — стр. 113
- 2.6.3. Как сохранить полезные страницы фильтрации — стр. 115
- 2.6.4. Шаблон принятия решения: индексировать, канонизировать, закрывать, удалять — стр. 116
Показывает, почему пагинация нарушает передачу сигналов, как оформлять последовательные страницы и как аудировать списки по семи точкам контроля. Разбирает бесконечную прокрутку и кнопку «Показать ещё».
- 2.7.1. Почему пагинация нарушает работу сигналов — стр. 118
- 2.7.2. Правила оформления последовательных страниц списка — стр. 120
- 2.7.3. Аудит пагинации в категориях и блогах: 7 точек контроля — стр. 121
- 2.7.4. Бесконечная прокрутка (Infinite Scroll) и кнопка «Показать еще» (Load More) — стр. 122
Описывает mobile-first индексацию и последствия клиентского рендеринга: потерю контента и разметки. Даёт способы проверить, что робот видит основной контент, включая пакетный поиск проблем с помощью ИИ.
- 2.8.1. Mobile-First Indexing на практике: правило содержательного равенства — стр. 126
- 2.8.2. Что ломается при клиентской отрисовке (CSR) и как выбрать архитектуру рендеринга — стр. 127
- 2.8.3. Инструментальная проверка: как убедиться, что робот видит весь контент — стр. 129
- 2.8.4. ИИ-помощник для пакетного поиска участков с неполной отрисовкой — стр. 131
Объясняет метрики LCP, CLS и INP, различие лабораторных и полевых данных и порядок диагностики на уровне шаблонов. Помогает ставить разработчикам задачи по скорости без переписывания фронтенда.
- 2.9.1. LCP, CLS, INP: из чего складываются метрики и что их ухудшает — стр. 134
- 2.9.2. Диагностика масштаба: что исправлять в шаблоне, а что на отдельной странице — стр. 136
- 2.9.3. Как не путать лабораторные замеры (Lighthouse) с полевыми данными (CrUX) — стр. 136
- 2.9.4. Практика быстрых улучшений без переписывания фронтенда — стр. 137
Определяет, когда hreflang необходим, перечисляет десять частых ошибок и методику проверки языковых кластеров. Полезен для мультиязычных и мультирегиональных проектов.
- 2.10.1. Когда hreflang необходим, а когда создает лишнюю сложность — стр. 141
- 2.10.2. Десять частых ошибок при внедрении hreflang — стр. 142
- 2.10.3. Методика проверки и аудита языковых кластеров — стр. 144
Собирает техническую диагностику в рабочий процесс: порядок первичного разбора в GSC, сведение данных краулера, сервера и индексации, группировка задач с помощью ИИ и контроль регрессий. Превращает разовый аудит в регулярную практику.
- 2.11.1. Порядок первичной диагностики в Google Search Console — стр. 148
- 2.11.2. Сведение данных краулера, сервера и индексации в единую матрицу — стр. 149
- 2.11.3. Применение ИИ для группировки и приоритизации технических задач — стр. 150
- 2.11.4. Регламент внедрения исправлений и контроль регрессии — стр. 152
Глава 3. Внутренняя оптимизация страницы (on-page SEO) (стр. 156)
Описывает оптимизацию отдельной страницы как решение задачи пользователя: интент, сущности, извлекаемые блоки, сниппет, изображения, микроразметка и шаблоны. Практичность главы в готовых правилах для семи типов страниц и регламентах проверки.
3.1. Типы страниц и правила их профильной оптимизации — стр. 157
Даёт профильные правила для главной, категории, карточки товара, услуги, статьи, локальной страницы и страницы онлайн-инструмента. Позволяет собрать ТЗ на страницу по её роли в архитектуре.
- 3.1.1. Главная страница: верификация бренда и маршрутизация веса — стр. 158
- 3.1.2. Страница категории (Листинг) — стр. 160
- 3.1.3. Карточка товара (Product Page) — стр. 163
- 3.1.4. Страница услуги (Service Page): — стр. 168
- 3.1.5. Информационная статья или руководство — стр. 172
- 3.1.6. Локальная посадочная страница — стр. 175
- 3.1.7. Функционально-коммерческая страница онлайн-инструмента (Functional Tool Page) — стр. 178
- Резюме раздела 3.1. — стр. 187
Разбирает проектирование Title и Description: как писать их под задачу, почему Google их переписывает, как влияют AI-ответы на CTR. Содержит матрицы шаблонов по типам страниц и пакетную подготовку черновиков.
- 3.2.1. Как писать Title под задачу страницы — стр. 189
- 3.2.2. Когда и почему Google переписывает Title — стр. 191
- 3.2.3. Meta Description как инструмент управления кликом и сниппетом — стр. 192
- 3.2.4. Матрица формул и шаблонов Title и Description по типам страниц — стр. 193
- 3.2.5. Пакетная подготовка черновиков Title и Description с помощью — стр. 194
- 3.2.6. Влияние AI-ответов на CTR выдачи и адаптация стратегии метатегов — стр. 195
Определяет полезный основной контент через вложенный труд и оригинальность, учит писать полно и коротко и отсекать мусорный объём. Отдельно разбирает таблицы для извлечения данных ИИ-системами.
- 3.3.1. Что такое полезный основной контент: метрики contentEffort и Information Gain — стр. 198
- 3.3.2. Как писать коротко, но достаточно полно: формула смыслового блока — стр. 199
- 3.3.3. Где заканчивается раскрытие темы и начинается мусорный объем — стр. 201
- 3.3.4. Как увязать текст с целевым действием: купить, выбрать, сравнить, понять, связаться — стр. 202
- 3.3.5. Оптимизация таблиц для извлечения данных AI-системами Google — стр. 203
- Выводы по разделу 3.3 — стр. 206
Описывает работу с сущностями, характерными терминами и смысловой полнотой документа. Помогает превратить текст из набора ключевых фраз в описание конкретного объекта с проверяемыми атрибутами.
- 3.5.1. Что такое сущности в поиске и как устроена их иерархия на странице — стр. 208
- 3.5.2. Механика EntityAnnotations: как Google распознает и взвешивает объекты — стр. 209
- 3.5.3. Снятие неоднозначности (Disambiguation): как исключить смешение смыслов — стр. 211
- 3.5.4. Query-Based Salient Terms (QBST) и салиентные термины темы — стр. 212
- 3.5.5. Поиск недостающих сущностей и терминов через анализ SERP — стр. 213
- 3.5.6. Применение ИИ для извлечения сущностей, терминов и аудита покрытия темы — стр. 214
Систематизирует элементы сниппета и расширенных результатов: название сайта, иконки, структурные блоки, визуальные элементы. Помогает решать, какие улучшения заметности стоит делать на конкретной странице.
- 3.6.1. Борьба за реальный клик и анатомия микрорешения в SERP — стр. 218
- 3.6.2. Сниппет и получение трафика в эпоху AI Overviews и AI Mode — стр. 220
- 3.6.3. Карта расширенных элементов сниппета (Rich Results) на октябрь 2026 года — стр. 221
- 3.6.4. Синхронизация сниппета с первым экраном и регламент CTR-аудита — стр. 224
- 3.6.5. Структурные элементы страницы: FAQ, списки, таблицы и блоки сравнения в пользовательском сценарии — стр. 225
- 3.6.6. Как готовить страницу под расширенный фрагмент (Featured Snippet) и нулевую позицию — стр. 230
- 3.6.7. Диагностика низкого CTR: что делать, если страница ранжируется, но не получает кликов — стр. 232
Показывает, как изображения участвуют в оценке оригинальности и подтверждении опыта: alt, figcaption, оригинальные медиа, пакетная работа и генерация сценариев по маске продукта. Ценен для e-commerce и экспертных обзоров.
- 3.7.1. Атрибут alt, подписи (<figcaption>) и текстовое окружение изображения — стр. 238
- 3.7.2. Как изображения усиливают понимание страницы и сигналы сущностей — стр. 239
- 3.7.3. Ошибки шаблонных alt-текстов и проектирование динамических формул в CMS — стр. 241
- 3.7.4. ИИ для создания черновиков alt и пакетного аудита медиа-контекста — стр. 242
- 3.7.5. ИИ для генерации изображений — стр. 244
- Выводы по разделу 3.7 — стр. 248
Описывает микроразметку Schema как машиночитаемый слой сущностей и связный граф JSON-LD. Даёт практику проверки, где разметка должна совпадать с видимым содержанием страницы.
- 3.8.1. Когда разметка приносит результат (и когда приводит к санкциям) — стр. 249
- 3.8.2. Рабочие типы разметки: Article, Product, Review, LocalBusiness и Organization — стр. 250
- 3.8.3. Формат JSON-LD и связывание сущностей страницы в единый граф (@graph и @id) — стр. 255
- 3.8.4. Разметка как инструмент снятия неоднозначности сущностей и ее роль в AI-поиске — стр. 258
- 3.8.5. Применение ИИ для генерации и аудита JSON-LD с обязательной ручной проверкой — стр. 259
- Выводы по разделу 3.8 — стр. 261
Собирает всё в шаблоны внутренней оптимизации для CMS и регламенты проверки страниц, включая защиту лидеров через Protected Cohort. Ценен при массовых обновлениях, чтобы не потерять трафик.
- 3.9.1. Проверочный чек-лист и матрица шаблона для информационной статьи — стр. 262
- 3.9.2. Проверочный чек-лист и матрица шаблона для категории (листинга) — стр. 264
- 3.9.3. Проверочный чек-лист и матрица шаблона для страницы услуги — стр. 266
- 3.9.4. Проверочный чек-лист и матрица шаблона для карточки товара — стр. 268
- 3.9.5. Безопасное внедрение массовых улучшений: как обновить шаблоны и не навредить сильным страницам — стр. 269
Глава 4. Архитектура сайта и внутренняя перелинковка (стр. 277)
Поднимает оптимизацию с уровня страницы на уровень домена: тематический фокус, роли страниц, хабы, перелинковка и отраслевые архитектуры. Помогает проектировать структуру, которая накапливает авторитет, а не размывает его.
4.1. Тематический фокус сайта и векторные границы домена — стр. 277
Объясняет тематический фокус как измеряемую концентрацию домена вокруг связанных тем и его векторные границы. Даёт аргументы для тематической чистки и отказа от нецелевых разделов.
- 4.1.1. Почему стратегия «писать обо всем» ослабляет видимость сайта — стр. 278
- 4.1.2. Векторная математика домена: как работают siteFocusScore и siteRadius — стр. 280
- 4.1.3. Диагностика тематического расползания и регламент профильной чистки (Topical Pruning) — стр. 281
- 4.1.4. Вертикальное и горизонтальное расширение: как масштабировать сайт без потери фокуса — стр. 283
- Выводы по разделу 4.1 — стр. 285
Описывает иерархию разделов и роли страниц от главной к целевым, смешанным и вспомогательным, а также реконструкцию запутанной структуры. Содержит матрицу решений по каждому URL при перестройке старых сайтов.
- 4.2.1. Главные разделы, подразделы и посадочные страницы: иерархия ролей — стр. 286
- 4.2.2. Категории, теги, фильтры, коллекции и спецстраницы: дисциплина вторичных таксономий — стр. 290
- 4.2.3. Как не плодить пустые и малоценные URL: входные фильтры и квоты наполнения — стр. 292
- 4.2.4. Реконструкция архитектуры: что делать, если структура сайта росла хаотично много лет — стр. 294
Раскрывает хабы, кластеры и семантические коконы как одну архитектурную идею с разной детализацией. Помогает выбирать модель тематического узла под размер и тип проекта.
- 4.3.1. Модель «Опорная страница плюс поддерживающие материалы» — стр. 300
- 4.3.2. Теория и практика семантических коконов v3.1 — стр. 304
- 4.3.3. Гранулярность: когда нужен один емкий документ, а когда серия страниц — стр. 309
- 4.3.4. Стыковка информационных и коммерческих URL — стр. 312
- 4.3.5. Применение ИИ для проектирования хаба и карты дочерних материалов — стр. 316
Показывает внутреннюю перелинковку как управление передачей веса и пониманием сайта: типы ссылок, анкоры, анкорные листы. Практически применим для расчёта ссылок между материнскими, дочерними и сестринскими страницами.
- 4.4.1. Навигационная, контекстная и шаблонная перелинковка — стр. 320
- 4.4.2. Как выбирать доноров для усиления нужной страницы — стр. 323
- 4.4.3. Анкоры во внутренней перелинковке — стр. 325
- 4.4.4. Ошибки перелинковки: сироты, тупики, переизбыток ссылок, шумные блоки — стр. 328
- 4.4.5. ИИ для поиска упущенных внутренних связей — стр. 330
Даёт архитектуру коммерческого каталога: какие страницы борются за спрос, какие поддерживают, какие закрываются. Разбирает фильтры, карточки, подборки и сравнения для интернет-магазинов.
- 4.5.1. Категории товаров — стр. 334
- 4.5.2. Подкатегории — стр. 337
- 4.5.3. Фильтры с SEO-потенциалом — стр. 339
- 4.5.4. Карточки товара — стр. 341
- 4.5.5. Связки «категория - подборка - бренд - сравнение» — стр. 344
- 4.5.6. Прикладные приемы семантической верстки и оптимизации карточки товара — стр. 347
Описывает распределение спроса по страницам сайта услуг: услуги, города, специализации и проблемы клиентов. Помогает избежать каннибализации и шаблонных гео-страниц.
- 4.6.1. Главная услуга и подуслуги — стр. 353
- 4.6.2. Геозависимые посадочные страницы — стр. 356
- 4.6.3. Кейсы, отзывы, вопросы и ответы как усилители страницы услуги — стр. 360
- 4.6.4. Защита от шаблонных клонов под города и услуги — стр. 363
Предлагает архитектуру медиа, баз знаний и корпоративных журналов, где публикации накапливают тематический авторитет. Показывает, как связывать материалы, чтобы не плодить сироты и дубли.
- 4.7.1. Рубрики и темы — стр. 367
- 4.7.2. Серии материалов — стр. 369
- 4.7.3. Гайды, сравнения, словари, подборки, рейтинги — стр. 372
- 4.7.4. Рефакторинг контентного фонда: когда объединять статьи, а когда дробить — стр. 375
Объясняет, как масштабировать проект, не снижая качества: расширение ядра, контроль новых документов, повторные проверки. Полезен командам, которые наращивают число страниц.
- 4.8.1. Правила расширения сайта новыми страницами — стр. 379
- 4.8.2. Принятие решения о создании нового раздела — стр. 381
- 4.8.3. Ревизия и зачистка слабых зон без разрушения связности — стр. 383
- 4.8.4. Применение ИИ для кластеризации тем и проектирования будущей структуры — стр. 386
Глава 5. Качество, доверие, локальное SEO и рабочие процессы (стр. 392)
Объединяет качество сайта, E-E-A-T, YMYL, авторов, локальное SEO, ИИ в производстве контента, измерение и постоянные улучшения. Практическая ценность главы - проверяемая инфраструктура доверия и операционный ритм команды.
5.1. Качество сайта глазами Google — стр. 393
Показывает, как поиск оценивает качество на уровне документа, раздела и домена, и какие общесайтовые сигналы диагностировать. Помогает отличить локальную проблему от проблемы проекта.
- 5.1.1. Полезность страницы и сайта — стр. 394
- 5.1.2. Почему сильное техническое SEO не спасает слабое содержание — стр. 396
- 5.1.3. Поиск и устранение системных слабостей качества — стр. 399
Разбирает E-E-A-T как инфраструктуру доверия, а не набор плашек: ответственность бизнеса, подтверждение опыта, прозрачность. Даёт список элементов, которые можно внедрить и проверить.
- 5.2.1. Что реально стоит за E-E-A-T — стр. 405
- 5.2.2. Когда практический опыт автора важнее академической экспертности — стр. 407
- 5.2.3. Какие элементы доверия должны быть на сайте — стр. 410
- 5.2.4. Почему E-E-A-T нельзя «вставить блоком», если сайт в целом слабый — стр. 415
Описывает зоны YMYL по руководству для асессоров и повышенные требования к ним. Помогает выстроить редакционную проверку и дисклеймеры для финансовых, медицинских и юридических тем.
- 5.3.1. Какие темы относятся к YMYL — стр. 418
- 5.3.2. Что значит «высокая цена ошибки» для контента — стр. 421
- 5.3.3. Как оформлять материалы в медицине, финансах, праве и безопасности — стр. 423
- 5.3.4. Проверка фактов, ссылки на источники и редакционная ответственность — стр. 426
Показывает, как строить профили авторов, редакционную политику и внешнюю репутацию. Важен для доказательства опыта автора, которое поиск проверяет вне сайта.
- 5.4.1. Страницы авторов — стр. 428
- 5.4.2. Редакционная политика — стр. 431
- 5.4.3. Контакты, компания и операционные доказательства опыта — стр. 432
- 5.4.4. Выстраивание доверия для молодых сайтов и новых брендов — стр. 434
Описывает локальное SEO: офлайн-интент, Google Business Profile, согласованность NAP и синхронизацию гео-кластеров. Полезен филиальным сетям и локальному бизнесу.
- 5.5.1. Когда локальная видимость определяет результат — стр. 437
- 5.5.2. Профиль компании в Google — стр. 438
- 5.5.3. Офлайн-специфика локальных посадочных страниц — стр. 440
- 5.5.4. Целостность NAP-данных, зоны обслуживания и маршрутизация отзывов — стр. 441
- 5.5.5. Локальные сущности и микроразметка филиалов — стр. 442
- 5.5.6. Как связать локальное SEO с общим сайтом — стр. 444
Определяет, как использовать ИИ в контент-процессах без риска масштабного спама: критерии отбраковки, роли человека, проверка фактов. Даёт регламент для редакционного конвейера.
- 5.6.1. Операционные зоны ускорения в редакционном конвейере — стр. 447
- 5.6.2. Канонический источник истины, извлечение структуры и подготовка черновиков — стр. 448
- 5.6.3. Почему нельзя отдавать публикацию ИИ без редактора — стр. 450
- 5.6.4. Рабочий конвейер от черновика и экспертной проверки до публикации — стр. 451
- 5.6.5. Контроль галлюцинаций, ложной экспертности и шаблонности — стр. 452
Разделяет рост трафика на видимость, кликабельность и результат после клика и учит измерять каждый слой. Помогает строить отчёты, по которым можно принимать решения.
- 5.7.1. Целевые метрики результата от показов и видимости до лидов и выручки — стр. 454
- 5.7.2. Google Search Console как основной источник сигналов по органике — стр. 455
- 5.7.3. Аналитика генеративной выдачи — стр. 456
- 5.7.4. Проверка влияния изменений на уровне страниц и разделов — стр. 458
- 5.7.5. ИИ для группировки запросов, страниц и поиска аномалий в данных — стр. 459
Описывает цикл улучшений, а не разовые кампании: ревизии, обновления, еженедельный ритм и очереди задач. Превращает SEO в управляемый процесс.
- 5.8.1. Формирование и фильтрация рабочей очереди SEO-задач — стр. 462
- 5.8.2. Регламент еженедельных, ежемесячных и ежеквартальных работ — стр. 464
- 5.8.3. Локализация масштаба сбоя и выбор между точечной правкой и пересборкой раздела — стр. 466
- 5.8.4. Организация рабочего ритма для соло-специалиста и команды — стр. 468
Глава 6. Линкбилдинг (стр. 471)
Рассматривает ссылки и упоминания как мультипликатор уже подготовленной системы: естественный профиль, выбор страниц-акцепторов, белые методы, анализ конкурентов, риски и учёт. Ценна тем, что связывает внешние сигналы с внутренней архитектурой.
6.1. Роль ссылок в 2026-2027 годах — стр. 473
Объясняет изменение роли ссылок в 2026-2027 годах: от точечного усиления запроса к подтверждению авторитета сущностей и распределению веса по кластеру. Задаёт ожидания от линкбилдинга.
- 6.1.1. Почему ссылки все еще работают, но уже не как в старых схемах — стр. 474
- 6.1.2. Ссылки, упоминания, брендовые сигналы и доверие — стр. 476
- 6.1.3. Когда проблема точно не в ссылках — стр. 478
Описывает признаки естественного и сбалансированного профиля, соответствующего бизнесу и тематике. Помогает оценивать свой профиль и профили конкурентов.
- 6.2.1. Разные типы доноров — стр. 481
- 6.2.2. Разные типы страниц-акцепторов — стр. 483
- 6.2.3. Анкоры - брендовые, нейтральные, с частичным вхождением и адресные — стр. 484
- 6.2.4. Доля и темп прироста ссылок — стр. 486
Учит выбирать страницы-акцепторы и готовить их до получения ссылок. Предупреждает, что неподготовленная страница поглощает ресурс даже сильных внешних ссылок.
- 6.3.1. Главная страница — стр. 488
- 6.3.2. Категории товаров — стр. 489
- 6.3.3. Страницы услуг — стр. 490
- 6.3.4. Исследования, инструменты, калькуляторы, гайды — стр. 491
- 6.3.5. Защита бюджета от слива — стр. 492
- 6.3.6. Неочевидные критерии выбора акцепторов и проектирование под ИИ-цитирование — стр. 493
Собирает белые методы получения ссылок: цифровой PR, данные, экспертные комментарии, партнёрские материалы. Полезен как набор рабочих сценариев с понятными условиями.
- 6.4.1. Ссылки через реально полезный материал — стр. 496
- 6.4.2. Гостевые публикации — стр. 497
- 6.4.3. Партнерские размещения — стр. 503
- 6.4.4. Цифровой PR и дата-журналистика — стр. 505
- 6.4.5. Цитирования, подборки и комментарии эксперта — стр. 508
- 6.4.6. Локальные ссылки для регионального SEO — стр. 512
Показывает, как работать с существующими упоминаниями бренда, нелинкованными и некорректными ссылками. Это самый дешёвый источник ссылок для проектов с узнаваемостью.
- 6.5.1. Ненаследованные упоминания бренда — стр. 515
- 6.5.2. Потерянные ссылки и их возврат — стр. 517
- 6.5.3. Упоминания продуктов, авторов, исследований и инструментов — стр. 518
- 6.5.4. Превращение цитируемости в ссылки — стр. 519
- 6.5.5. Скрытые паттерны линкбилдинга — стр. 520
Описывает анализ ссылочных стратегий конкурентов, включая ИИ-поддержку. Помогает понять, за что конкурентам ссылаются и какие активы нужны для сопоставимых размещений.
- 6.6.1. Какие ссылки конкурентов действительно стоит повторять — стр. 524
- 6.6.2. Как искать страницы, которые стабильно притягивают ссылки — стр. 526
- 6.6.3. ИИ для группировки ссылочных паттернов конкурентов — стр. 530
- 6.6.4. Продвинутые ИИ-механики реверс-инжиниринга: анализ контекста, сущностей и перехват ссылочного распада — стр. 532
Разбирает риски: токсичные размещения, исчезающие ссылки, бесполезный трафик. Даёт критерии защиты бюджета и проверки подрядчиков.
- 6.7.1. Признаки искусственного размещения: что проверять в ссылке и вокруг неё — стр. 538
- 6.7.2. Схемы с повышенным риском для новых и небольших сайтов — стр. 540
- 6.7.3. Как проверять предложения по ссылкам и работу подрядчика — стр. 543
- 6.7.4. Когда приостановить размещения и сначала исправить сайт — стр. 545
Предлагает систему планирования, учёта и связи линкбилдинга с развитием сайта. Позволяет отследить путь от темы и материала до публикации и результата.
- 6.8.1. Минимальная рабочая система для небольшого сайта — стр. 549
- 6.8.2. Как организовать линкбилдинг в среднем бизнесе — стр. 552
- 6.8.3. Как учитывать площадки, размещения, страницы и результаты — стр. 554
- 6.8.4. Как связывать линкбилдинг с контент-планом и релизами — стр. 558
Описывает нестандартные приёмы: инструменты, цитируемые данные, воспроизводимые расчёты и профессиональный вклад. Полезен для получения ссылок в нишах, где обычный аутрич слабо работает.
- 6.9.1. Ссылка на воспроизводимый сценарий вместо главной страницы инструмента — стр. 561
- 6.9.2. Цитируемые версии данных и программ: DOI, репозитории и файлы цитирования — стр. 563
- 6.9.3. Повторно используемые графики и данные с понятной атрибуцией — стр. 564
- 6.9.4. Включение продукта в независимую систему испытаний — стр. 565
- 6.9.5. «Тихое спонсорство» рабочего инструмента: узкая аудитория вместо покупки показателя домена — стр. 566
- Методика доказательного исследования до написания текста: аудитория, сайт, конкуренты
- TGA: проверка, нужен ли отдельный URL
- GIST: ядро страницы, доказательства и ограничения без раздувания объема
- Семантические коконы 4.0: граф задач, единственный структурный дом страницы, единый источник изменяемых фактов
- Описание рабочих промптов и скиллов: Cocoon Engine X4, Chainsmith, GEO Structure Optimizer, BrandCore, CVD, VeriScan, CHUNK SENTINEL, TEXT HUMANIZATION и других
Описывает цикл доказательного исследования до написания текста: данные, связки, интенты, кластеры, проверка необходимости страницы через TGA и ядро страницы по GIST. Ценность главы - методика, которая позволяет не создавать лишних страниц и не писать «воду».
7.1. Постановка задачи и границы исследования — стр. 569
Показывает, как поставить исследовательскую задачу и определить её границы на примере магазина. Помогает избежать сбора запросов без цели.
- 7.1.1. Цели, аудитория, рынок и ограничения — стр. 569
- 7.1.2. Новый сайт и существующий раздел — стр. 571
- 7.1.3. Что исключаем из исследования — стр. 572
- 7.1.4. Паспорт проекта и режим доказательности — стр. 573
Описывает сбор и проверку исходных данных: обращения, отзывы, страницы сайта и конкурентов, выгрузки. Задаёт стандарт, на который опираются выводы.
- 7.2.1. Поисковые данные и вопросы клиентов — стр. 577
- 7.2.2. Фиксация источника, периода и области просмотра — стр. 579
- 7.2.3. Очистка без потери исходных формулировок — стр. 581
- 7.2.4. Частотность, важность и неопределённость — стр. 583
Учит строить исследовательские связки от широкого поиска к проверке и отличать повторяющийся сигнал от единичного случая. Снижает риск принимать случайность за закономерность.
- 7.3.1. Широкая разведка и узкие направления — стр. 585
- 7.3.2. Сегменты и контрпримеры — стр. 587
- 7.3.3. До выбора и после использования — стр. 589
- 7.3.4. Международные наблюдения и пределы переноса — стр. 591
Раскрывает интенты, модификаторы и задачи пользователей. Помогает определить, какое решение стоит за запросом, и как оно влияет на тип страницы.
- 7.4.1. Сущность, задача и поисковая формулировка — стр. 593
- 7.4.2. Критерии выбора, ограничения и ошибки — стр. 595
- 7.4.3. Явные и скрытые задачи — стр. 597
- 7.4.4. Нецелевые задачи и запрещённые обещания — стр. 599
Описывает кластеризацию формулировок и проверку по выдаче. Показывает, когда запросы можно объединять, а когда они требуют разных ответов.
- 7.5.1. Предварительная группировка — стр. 602
- 7.5.2. Состав и форматы результатов — стр. 604
- 7.5.3. Смешанная и нестабильная выдача — стр. 605
- 7.5.4. Проверка машинной группировки — стр. 607
Сопоставляет аудиторию, сайт и конкурентов, чтобы выявить реальные дефициты, а не копировать чужие блоки. Помогает решать, нужна ли конкурентная таблица или блок.
- 7.6.1. Подготовка трёх раздельных корпусов — стр. 610
- 7.6.2. Полнота получения страниц — стр. 612
- 7.6.3. Проверка отрицательных выводов — стр. 614
- 7.6.4. Отличие, которое действительно нужно пользователю — стр. 616
Объясняет, как проверить через TGA, нужна ли отдельная страница или тема должна войти в существующую. Защищает от каннибализации и разрастания индекса.
- 7.7.1. Самостоятельность задачи и обещания — стр. 620
- 7.7.2. Раздел, поддержка, сравнение или новый URL — стр. 622
- 7.7.3. Поглощение существующей страницей — стр. 624
- 7.7.4. Отказ или дополнительная проверка — стр. 626
Описывает метод GIST: определить ядро страницы и отобрать смысловые блоки без избыточности. Даёт способ избежать «полного» документа, где нужное теряется.
- 7.8.1. Job и минимально необходимое ядро — стр. 630
- 7.8.2. Направления поиска отсутствующих узлов — стр. 634
- 7.8.3. Полезность, разнообразие и заменяемость — стр. 635
- 7.8.4. Сжатие с сохранением ограничений и доказательств — стр. 638
Показывает, как разделять подтверждённые сведения и гипотезы и когда нужно углубление исследования. Определяет статус доказательств перед публикацией.
- 7.9.1. Когда достаточно внутренних данных — стр. 641
- 7.9.2. Когда подключать внешнее исследование — стр. 643
- 7.9.3. Сила доказательства и переносимость — стр. 645
- 7.9.4. Механизм, изменение страницы и проверяемая гипотеза — стр. 647
Содержит практикум GIST: задание, документ, метаданные и аудит с сохранением версий и оснований изменений. Годится как регламент для редактора.
- 7.10.1. Выбор минимального маршрута — стр. 650
- 7.10.2. Подготовка одной контрольной страницы — стр. 651
- 7.10.3. Title, description, временные факты и fallback — стр. 654
- 7.10.4. Аудит, исправление и повторная проверка — стр. 656
Описывает итоговую карту страниц и передачу результатов исследования в проектирование. Помогает собрать пакет, который можно передать архитектору и редакции.
- 7.11.1. Существующие и новые страницы — стр. 659
- 7.11.2. Приоритеты, стоимость поддержки и зависимости — стр. 661
- 7.11.3. Источники, ограничения и разрешённые утверждения — стр. 663
- 7.11.4. Версии карты и пакет для главы 8 — стр. 664
Переводит исследование в архитектуру семантических коконов 4.0 на базе Cocoon Engine X4: границы, роли страниц, структурный дом, ссылки, факты и внедрение. Ценность - единая система планирования и обновления раздела, а не набор статей.
8.1. От модели 3.1 к семантическому кокону 4.0 — стр. 669
Объясняет переход от модели 3.1 к кокону 4.0 как управляемой системе ответов на связанные задачи. Показывает, чем он отличается от классического кластера.
- 8.1.1. Что меняется в единице планирования — стр. 670
- 8.1.2. Граф задач и структура навигации — стр. 672
- 8.1.3. Авторская методика и подтверждённые факты — стр. 674
- 8.1.4. Ограничения обещаний роста — стр. 675
Описывает подготовку материалов и рабочей сессии Cocoon Engine X4. Предупреждает, что устаревшие исходные данные искажают дальнейшие решения.
8.3. Границы кокона и граф сущностей — стр. 679
Показывает, как определить границы кокона и построить граф сущностей. Помогает отделить соседние направления от основного раздела.
8.4. Роли страниц и состав выпуска — стр. 681
Описывает роли страниц и состав выпуска. Позволяет планировать объём работ и не пытаться закрыть все задачи одним документом.
8.5. Единственный структурный дом и смысловые мосты — стр. 683
Вводит правило единственного структурного дома и смысловые мосты. Защищает от дублирования и обеспечивает переходы между связанными задачами.
8.6. Внутренние ссылки и их контекст — стр. 685
Учит проектировать внутренние ссылки с контекстом: какое действие поддерживает каждый переход. Даёт редактору понятные указания для размещения.
8.7. Контент кокона и проверка GIST — стр. 687
Описывает содержание кокона и проверку его через GIST. Объясняет, когда решение возвращается на архитектурный уровень.
8.8. Единый источник изменяемых фактов — стр. 689
Вводит единый источник изменяемых фактов: цен, совместимости, условий. Предотвращает противоречия между карточками, руководствами и метаданными.
8.9. Передачи и критерии готовности — стр. 691
Описывает передачи между этапами и критерии готовности. Помогает фиксировать, какие выводы подтверждены, а какие остаются предварительными.
8.10. Внедрение и проверка опубликованного кокона — стр. 693
Показывает, как внедрять кокон поэтапно и проверять опубликованные страницы. Снижает риски ошибок шаблона и адресов.
8.11. Аудит и точечное обновление — стр. 695
Описывает аудит и точечное обновление кокона при изменении продукта, аудитории или источников. Сохраняет основания прежних решений.
8.12. Сквозные практикумы и собственные связки — стр. 697
Содержит сквозные практикумы и способы собирать собственные связки. Показывает формы документов и решений, которые можно ожидать на каждом шаге.
8.13. Chainsmith - подготовка и выполнение маршрутов Cocoon Engine X4 — стр. 699
Описывает Chainsmith - мета-промпт, который собирает последовательность команд для Cocoon Engine X4. Упрощает освоение системы и подготовку маршрута под задачу.
Глава 9. Авторские инструменты для SEO - промпты, скиллы и рабочие связки (стр. 703)
Даёт справочник авторских промптов и скиллов с назначением, входными данными, результатом и ограничениями каждого. Ценен как карта инструментов, где указано, что можно доверить модели, а что нужно проверять вручную.
9.1. Cocoon Engine X4 и инструменты работы с ним — стр. 703
Описывает Cocoon Engine X4, Chainsmith, TGA, GIST, Reddit Mapper и GEO Structure Optimizer. Помогает выбрать инструмент для исследования, архитектуры, контента или структуры готовой страницы.
- 9.1.1. Cocoon Engine X4 — стр. 703
- 9.1.2. COCOON CHAINSMITH v3 — стр. 703
- 9.1.3. Topical Graph Architect и TGA Navigator — стр. 704
- 9.1.4. GIST Content Logic и ранняя система промптов GIST — стр. 705
- 9.1.5. Reddit Mapper V2 и исследовательский компонент X4 — стр. 705
- 9.1.6. GEO Structure Optimizer — стр. 706
Описывает BrandCore и BrandCore Navigator как проверяемый источник фактов о компании и Market-Scoped Differentiation как инструмент адаптации под рынки. Нужен при регулярном производстве контента для одного бренда.
- 9.2.1. BrandCore и BrandCore Navigator — стр. 707
- 9.2.2. Ultimate Market-Scoped Differentiation — стр. 707
Собирает инструменты исследования тем и спроса: Trend Discovery, InfoGapRadar, Latent Intent Analyst и Forensic SEO Due Diligence. Результаты рассматриваются как гипотезы для проверки.
- 9.3.1. Trend Discovery Prompt 4.0 — стр. 709
- 9.3.2. InfoGapRadar SEO Prompt — стр. 709
- 9.3.3. Latent Intent Analyst v2.2 — стр. 710
- 9.3.4. Forensic SEO Due Diligence — стр. 710
Описывает SEO TITAN OS, аудит по пайплайну ранжирования и SERP Barrier Breaker. Подчёркивает, что оценки промптов - не измерения Google.
- 9.4.1. SEO TITAN OS — стр. 711
- 9.4.2. Аудит страницы по пайплайну ранжирования Google — стр. 711
- 9.4.3. SERP Barrier Breaker — стр. 712
Описывает проверку и редактирование содержания: эмуляторы асессора, CVD, LinguaForensic, TEXT HUMANIZATION, LexAdapt и VeriScan. Разделяет оценку, диагностику и редактуру.
- 9.5.1. Эмуляторы асессора — стр. 713
- 9.5.2. CVD - Content Value Detector v2.3 — стр. 713
- 9.5.3. LinguaForensic AI Text Detector — стр. 714
- 9.5.4. TEXT HUMANIZATION by DrMax v1.6.1 — стр. 714
- 9.5.5. LexAdapt v1.5 — стр. 715
- 9.5.6. VeriScan v1.6 — стр. 715
Описывает SemanticRank Orchestrator, CHUNK SENTINEL и LSI 2.0 Auditor - проверку HTML-разметки и деления на фрагменты. Объясняет, когда достаточно структурной правки, а когда нужен анализ HTML.
- 9.6.1. SemanticRank Orchestrator — стр. 716
- 9.6.2. CHUNK SENTINEL v1.0 — стр. 716
- 9.6.3. LSI 2.0 Auditor для LLM-цитируемости — стр. 717
Описывает Entity Footprint System, Brand Entity Poisoning Forensics и Regulatory & Risk Scanner. Помогает находить расхождения о бренде и чувствительные утверждения до публикации.
- 9.7.1. Entity Footprint System — стр. 718
- 9.7.2. Brand Entity Poisoning Forensics v1 — стр. 718
- 9.7.3. Regulatory & Risk Scanner — стр. 719
Описывает Listicle Citation Engine, SignalForge и PromptSculptor. Закрывает внешние упоминания, контролируемые эксперименты и обслуживание рабочих промптов.
- 9.8.1. Listicle Citation Engine и работа с подборками — стр. 720
- 9.8.2. SignalForge и последовательная проверка изменений — стр. 721
- 9.8.3. PromptSculptor и обслуживание рабочих промптов — стр. 721
Сводит методологию обеих частей в единую систему координат и даёт порядок внедрения от технического фундамента до производства на TGA, GIST и Cocoon Engine X4. Полезно как финальный чек-лист приоритетов.
Приложения: чек-листы, промпт и команды (стр. 725)
Содержат рабочие чек-листы, промпт и справочник команд, которые можно использовать без перечитывания глав. Ценны как готовые инструменты для повседневной работы.
Приложение 1. Чек-лист по диагностике сайта после апдейта Google (стр. 725)
Чек-лист анализа сайта после апдейта Google, который запускают после завершения выкатки и паузы минимум в неделю. Помогает отделить реальное влияние от шума.
Приложение 2. Быстрый чек-лист по robots.txt для любого типа сайта (стр. 728)
Краткий чек-лист проверки robots.txt для любого типа сайта. Позволяет быстро выявить критические ошибки перед детальным аудитом.
Приложение 3. Промпт: Link Target Readiness Analyzer (стр. 729)
Промпт Link Target Readiness Analyzer для оценки готовности страницы принимать внешние ссылки. Помогает выбирать акцепторы до запуска линкбилдинга.
Приложение 4. Команды Cocoon Engine X4 (стр. 732)
Справочник команд Cocoon Engine X4 по реестру CP-Navigator v1.9: управление сессией, задачи, исследование, архитектура, GIST, экспорт и ввод задания простым текстом. Нужен для работы с системой без поиска по документации.
- Начало работы и управление сессией — стр. 732
- Темп работы и степень автономности — стр. 733
- Основные задачи — стр. 733
- Исследование аудитории и спроса — стр. 733
- Архитектура и состав страниц — стр. 734
- GIST и содержание страницы — стр. 734
- Управление составом пакета — стр. 735
- Факты, актуальность и готовность — стр. 735
- Служебная самопроверка Navigator — стр. 736
- Экспорт результатов — стр. 736
- Подтверждённые алиасы — стр. 736
- Ввод задания простым текстом — стр. 737
Автор DrMax
- С 2000 года занимается веб-разработкой, проектированием информационных систем и SEO
- Веб-разработчик, поисковый архитектор и создатель прикладных ИИ-систем
- Автор серии «SEO Монстр», учебника «Доказательное SEO 2026» и набора из 25+5 SEO-промптов для работы с нейросетями
- Его книги читают SEO-специалисты, разработчики и руководители команд
- 20+ книг за плечами
- 737 страниц, 9 глав, 4 приложения
- Правила для 7 типов страниц, чек-листы, код
- Уникальные авторские методы продвижения
- Полный разбор алгоритмов ранжирования Google
- Десятки авторских SEO-промптов
Подробнее:
Скрытое содержимое доступно для зарегистрированных пользователей!
Скачать:
Для просмотра скрытого содержимого вы должны войти или зарегистрироваться.

